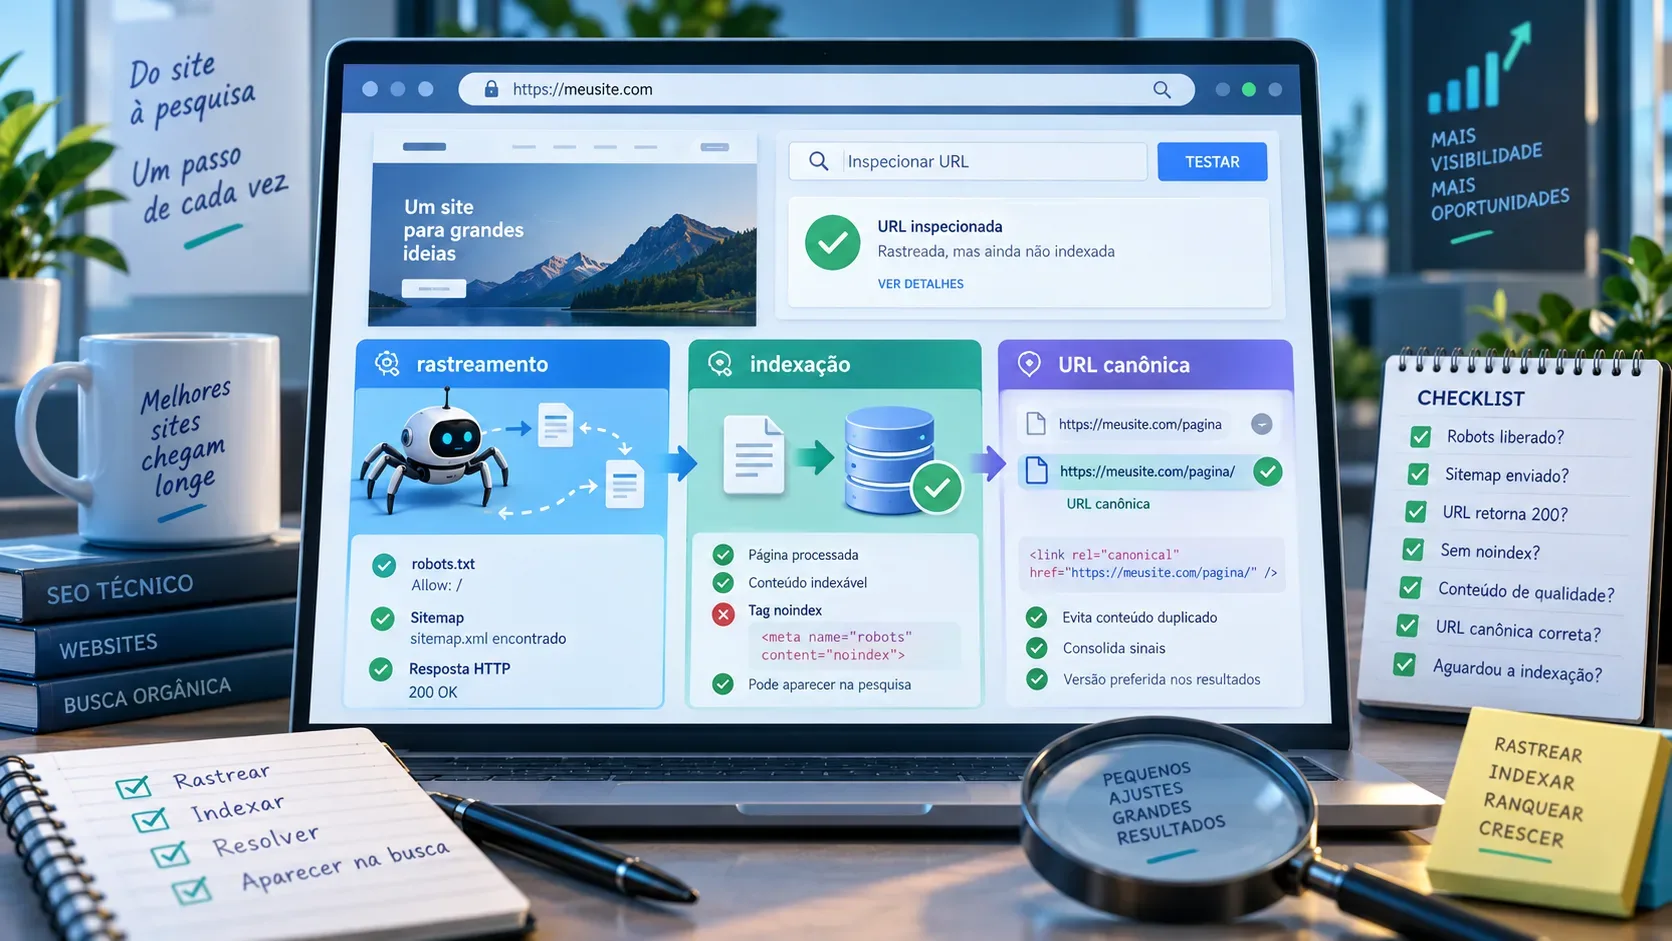
Se um site recém-publicado não aparece na Pesquisa Google, o primeiro passo é descobrir em qual etapa a URL parou. Descoberta significa que o Google conhece o endereço; rastreamento significa que tentou acessar a página; indexação significa que processou o conteúdo e decidiu incluí-lo em seu índice. A escolha da URL canônica define qual versão de páginas iguais ou semelhantes representa aquele conteúdo. Um site pode passar por uma etapa e não pela seguinte.
Não use a ausência em uma busca comum nem uma consulta com site: como diagnóstico definitivo. O operador não apresenta necessariamente todos os endereços indexados. Mesmo o status de URL indexada não garante exibição para uma pesquisa específica. A fonte principal do diagnóstico é a inspeção da URL exata no Search Console.
Comece pela inspeção da URL exata
Abra a propriedade verificada no Google Search Console e insira o endereço completo publicado, incluindo https, domínio, caminho e, quando aplicável, a barra final. Confira a versão com e sem www se ambas existirem. No relatório da versão conhecida pelo Google, leia estes campos antes de editar o site:
- Status de indexação: o URL está no Google ou qual motivo explica a exclusão?
- Detecção: o Google conhece a URL por um sitemap ou uma página de referência?
- Rastreamento: quando ocorreu a última visita, ela foi permitida e a busca da página teve sucesso?
- Indexação: a página permite indexação e quais são a URL canônica declarada pelo site e a selecionada pelo Google?
Depois use Testar o URL publicado para verificar a versão atual, inclusive a resposta HTTP e, quando necessário, o HTML renderizado. O resultado armazenado pode estar desatualizado após uma correção. Já o teste ao vivo verifica a acessibilidade atual, mas não prevê a decisão de indexar nem a escolha canônica. Compare os dois, em vez de tratar um teste positivo como promessa de inclusão.
Checklist por sintoma: causa provável e próximo teste
Google ainda não conhece a URL
Se a inspeção informar que a URL é desconhecida, verifique se a página está ligada por links HTML navegáveis a partir de páginas relevantes do próprio site e se aparece no sitemap com o endereço absoluto e preferencial. Confira o envio e eventuais erros do sitemap no Search Console. Para uma página prioritária, teste o URL publicado e solicite indexação. Um sitemap ajuda na descoberta, mas não obriga o Google a rastrear ou indexar.
Descoberta, mas ainda não rastreada
O Google conhece o endereço, mas ainda não buscou seu conteúdo. Isso, por si só, não prova bloqueio ou erro de servidor. Confirme se o endereço é o pretendido, se está em links internos e sitemap e se o site responde de forma estável. Acompanhe o relatório e, quando disponíveis, os registros do servidor. Evite repetir solicitações de indexação: elas não tornam o rastreamento mais rápido.
Rastreamento bloqueado
Se O rastreamento é permitido? indicar Não, verifique a regra aplicável ao Googlebot no robots.txt. Revise também exigências de login ou restrições de acesso. Robots.txt controla o rastreamento, não é uma instrução confiável para remover uma URL do índice: um endereço bloqueado ainda pode aparecer sem seu conteúdo. Além disso, se o robô não acessa a página, não consegue ler uma eventual diretiva noindex nela.
Resposta HTTP ou página renderizada com problema
Uma página elegível precisa estar acessível, retornar HTTP 200 e conter conteúdo indexável. Verifique se o endereço entrega 404, 5xx, redireciona inesperadamente ou exige autenticação. Se houver redirecionamento legítimo, inspecione também a URL de destino. Mesmo com 200, uma página praticamente vazia ou que exibe mensagem de erro pode ser tratada como soft 404. Confira o HTML e a captura renderizada na inspeção, sobretudo se o conteúdo depende de JavaScript.
Rastreada, mas não indexada
O Google buscou a página, mas isso não significa que decidiu indexá-la. Confira no HTML ou no cabeçalho HTTP se há meta robots noindex ou X-Robots-Tag noindex; remova a diretiva apenas se a publicação deve ser pública. Se não houver impedimento explícito, compare o conteúdo principal com outras páginas, examine a renderização e verifique se a página oferece informação própria e útil. O relatório pode refletir um rastreamento anterior à correção.
Outra URL foi escolhida como canônica
Compare a URL canônica declarada pelo site com a selecionada pelo Google no relatório indexado. Se o Google escolheu a versão correta de uma página duplicada, a exclusão da alternativa pode ser esperada. Se escolheu a versão errada, alinhe links internos, URLs do sitemap, redirecionamentos quando apropriados e a indicação rel=canonical, preferencialmente autorreferencial na versão principal. Não use noindex ou robots.txt como solução de canonização: a indicação canônica é uma preferência, não uma ordem.
A página é nova e o teste atual não mostra erro
Depois de corrigir problemas concretos, aguarde e acompanhe a inspeção. O Google informa que o rastreamento pode levar de alguns dias a algumas semanas, e solicitar indexação não garante inclusão nem posicionamento. Guarde a data da publicação e da correção para diferenciar demora normal de um problema persistente.
O próximo passo depende do resultado
- URL desconhecida: melhore a descoberta com links internos e sitemap; teste a URL.
- Bloqueio ou falha HTTP: corrija acesso, regras e resposta do servidor antes de solicitar indexação.
- Noindex ou renderização incompleta: corrija a versão publicada e repita o teste ao vivo.
- Canônica inesperada: alinhe os sinais entre versões e inspecione a página escolhida pelo Google.
- Página acessível e indexável, ainda fora do índice: solicite indexação uma vez para URLs prioritárias, acompanhe o estado e revise utilidade e duplicação se a situação persistir.
Se o relatório disser que a URL está no Google, mas ela não aparecer em uma busca, verifique a consulta realizada, o relatório de desempenho e eventuais ações manuais, problemas de segurança ou remoções. Isso é diferente de uma falha de rastreamento ou de indexação. O teste site: é auxiliar, não inventário completo.
Checklist final
- A URL exata está correta e incluída nos links internos ou no sitemap?
- O Googlebot pode acessar a página sem bloqueio ou login?
- A resposta final é HTTP 200 e o conteúdo principal aparece na versão renderizada?
- Não existe noindex involuntário em HTML ou cabeçalho HTTP?
- A URL canônica declarada e a escolhida pelo Google fazem sentido?
- A versão atual foi testada e a evolução será conferida sem expectativa de indexação garantida?
Fontes oficiais do Google para aprofundar o diagnóstico: inspeção de URL, requisitos técnicos, envio de sitemaps, orientações sobre URL canônica, solicitação de novo rastreamento e limitações do operador site:.